Wer Large Language Models lokal mit Programmen wie LM Studio, Ollama oder llama.cpp betreibt, stößt relativ schnell auf Bezeichnungen wie:
Q4_K_M
Q5_K_M
Q8_0
GGUF
30B-A3B
8x7B MoE
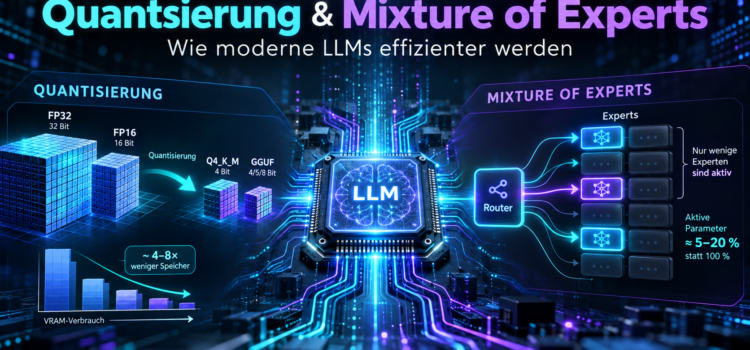
Dahinter verbergen sich zwei besonders wichtige Techniken moderner Large Language Models:
- Quantisierung reduziert den Speicherbedarf der Modellgewichte.
- Mixture of Experts (MoE) reduziert die Anzahl der Parameter, die für die Berechnung eines Tokens tatsächlich aktiv verwendet werden.
Beide Techniken verfolgen also das Ziel, große Modelle effizienter zu machen. Sie setzen dabei jedoch an vollkommen unterschiedlichen Stellen an.
Gerade für lokale KI-Systeme ist dieser Unterschied entscheidend.
Warum benötigen LLMs so viel Speicher?
Ein Large Language Model besteht aus Milliarden von Parametern. Diese Parameter sind im Wesentlichen Zahlenwerte innerhalb großer Matrizen.
Ein Modell mit beispielsweise
30 Milliarden Parametern
muss entsprechend ungefähr 30 Milliarden solcher Werte speichern.
Wie viel Speicher benötigt wird, hängt davon ab, mit welchem Datentyp diese Werte gespeichert werden.
Bei FP32 benötigt jeder Wert 32 Bit beziehungsweise vier Byte:
30.000.000.000 × 4 Byte
≈ 120 GB
Bei FP16 beziehungsweise BF16 sind es zwei Byte:
30.000.000.000 × 2 Byte
≈ 60 GB
Bereits hier sieht man das Problem: Ein 30B-Modell passt selbst in FP16 nicht annähernd in den Grafikspeicher einer normalen Consumer-GPU.
Hier kommt die Quantisierung ins Spiel.
Was bedeutet Quantisierung?
Bei der Quantisierung werden die Gewichte des Modells mit geringerer numerischer Präzision gespeichert.
Statt beispielsweise 16 Bit pro Gewicht verwendet man nur noch ungefähr:
8 Bit
6 Bit
5 Bit
4 Bit
3 Bit
2 Bit
Die theoretische Rechnung ist einfach:
Speicher = Parameter × Bits pro Parameter / 8
Für ein 30B-Modell ergibt sich theoretisch:
| Präzision | Speicher für 30B Parameter |
|---|---|
| FP32 | 120 GB |
| FP16/BF16 | 60 GB |
| 8 Bit | 30 GB |
| 6 Bit | 22,5 GB |
| 5 Bit | 18,75 GB |
| 4 Bit | 15 GB |
| 3 Bit | 11,25 GB |
| 2 Bit | 7,5 GB |
Allerdings ist diese Rechnung nur eine erste Näherung.
Bei realen Quantisierungsverfahren müssen zusätzlich unter anderem Skalierungsfaktoren, Blockinformationen und teilweise höher aufgelöste Tensoren gespeichert werden.
Ein Q4_K_M-Modell ist deshalb nicht einfach ein Modell mit exakt vier Bit pro Parameter.
Was ist GGUF?
Bei lokalen LLMs begegnet einem besonders häufig das Dateiformat GGUF.
GGUF wird vom llama.cpp-Ökosystem verwendet und kann neben den eigentlichen Modellgewichten zahlreiche Metadaten enthalten, beispielsweise:
- Modellarchitektur
- Quantisierungstyp
- Tokenizer
- Vocabulary
- Kontextparameter
- RoPE-Konfiguration
- Chat-Templates
- Tensorinformationen
Dadurch kann eine einzelne .gguf-Datei im Idealfall bereits nahezu alles enthalten, was eine Inferenzanwendung benötigt.
Eine Datei könnte beispielsweise so heißen:
Qwen3-30B-A3B-Q4_K_M.gguf
Aus dem Namen können wir bereits mehrere Informationen ablesen:
Qwen3-30B-A3B
│
├── ungefähr 30 Milliarden Gesamtparameter
└── ungefähr 3 Milliarden aktive Parameter

Q4_K_M
│
└── verwendete Quantisierung
Programme wie llama.cpp können eine entsprechende GGUF-Datei direkt laden.
Was bedeutet Q4_K_M genau?
Eine der häufigsten Quantisierungen im llama.cpp-Umfeld ist:
Q4_K_M
Der Name lässt sich grob zerlegen in:
Q4
K
M
Q4
Q4 bedeutet, dass für einen großen Teil der Gewichte eine Quantisierung im Bereich von vier Bit verwendet wird.
Das bedeutet jedoch ausdrücklich nicht, dass jeder Parameter exakt vier Bit benötigt.
K
Das K bezeichnet die sogenannte K-Quantisierung.
Dabei werden Gewichte nicht einzeln unabhängig voneinander quantisiert, sondern blockweise beziehungsweise in größeren Superblöcken verarbeitet.
Bei Q4_K arbeitet llama.cpp beispielsweise mit Superblöcken und zusätzlichen Skalierungs- und Minimumwerten. Dadurch liegt der effektive Speicherbedarf der eigentlichen Q4_K-Repräsentation bei ungefähr 4,5 Bit pro Gewicht und nicht exakt vier Bit.
Das zusätzliche Speicherbudget ermöglicht eine bessere Rekonstruktion der ursprünglichen Gewichtswerte.
M
Das M steht für eine gemischte Quantisierung.
Nicht jeder Tensor eines Modells reagiert gleich empfindlich auf Quantisierung.
Deshalb werden bei Q4_K_M bestimmte Tensoren mit einer höheren Genauigkeit gespeichert als andere.
Aktuelle llama.cpp-Quantisierungsrezepte können beispielsweise neben Q4_K auch Q5_K- oder Q6_K-Tensoren innerhalb eines Q4_K_M-Modells verwenden. Welche Tensoren höher aufgelöst gespeichert werden, kann außerdem von der jeweiligen Modellarchitektur abhängen.
Q4_K_M bedeutet also vereinfacht:
Großteil des Modells:
≈ Q4_K

besonders empfindliche Tensoren:
teilweise höhere Präzision
Genau deshalb ist Q4_K_M häufig ein guter Kompromiss aus:
Dateigröße
Qualität
Geschwindigkeit
Speicherbedarf
Q4_K_S, Q4_K_M, Q5_K_M und Q8_0
Bei GGUF-Modellen findet man häufig mehrere Varianten desselben Modells:
Q4_K_S
Q4_K_M
Q5_K_S
Q5_K_M
Q6_K
Q8_0
Grob kann man sie folgendermaßen einordnen:
| Quantisierung | Speicher | Qualität |
|---|---|---|
| Q4_K_S | sehr niedrig | gut |
| Q4_K_M | niedrig | sehr guter Kompromiss |
| Q5_K_S | mittel | höher |
| Q5_K_M | mittel | sehr hoch |
| Q6_K | hoch | sehr nah am Original |
| Q8_0 | sehr hoch | minimale Quantisierungsverluste |
Dabei sollte man beachten, dass der Unterschied nicht bei jeder Aufgabe gleichermaßen sichtbar wird.
Bei einfachen Chats kann ein Q4_K_M-Modell praktisch genauso überzeugend wirken wie ein Q8-Modell.
Bei anspruchsvollen Aufgaben wie
- Softwareentwicklung
- Mathematik
- logischem Reasoning
- strukturierten Ausgaben
- Tool Calling
können sich stärkere Quantisierungen eher bemerkbar machen.
Konkretes Beispiel: Qwen3-30B-A3B
Ein gutes Beispiel ist Qwen3-30B-A3B.
Das Modell besitzt:
30,5 Milliarden Gesamtparameter
3,3 Milliarden aktive Parameter
128 Experts
8 aktive Experts pro Token
Es handelt sich also um ein Mixture-of-Experts-Modell.
Die offiziellen GGUF-Dateien zeigen sehr schön, welchen Einfluss die Quantisierung auf die Größe hat:
Q4_K_M : 18,6 GB
Q5_K_M : 21,7 GB
Q6_K   : 25,1 GB
Q8_0   : 32,5 GB
F16    : ca. 61 GB
Damit schrumpft das Modell von ungefähr 61 GB in F16 auf nur etwa 18,6 GB mit Q4_K_M.
Das entspricht einer Reduzierung um ungefähr 70 Prozent.
Die Rechnung
30,5 Milliarden × 4 Bit / 8
= 15,25 GB
würde dagegen einen zu niedrigen Wert liefern.
Die tatsächlichen 18,6 GB zeigen gut, warum man Q4_K_M nicht einfach als „vier Bit pro Parameter“ betrachten darf.
Dateigröße ist nicht gleich VRAM-Bedarf
Ein weiterer häufiger Denkfehler lautet:
Meine GGUF-Datei ist 14 GB groß und meine Grafikkarte hat 16 GB VRAM. Also passt das Modell problemlos hinein.
So einfach ist es leider nicht.
Während der Inferenz werden neben den Modellgewichten weitere Speicherbereiche benötigt.
Vereinfacht:
VRAM =
Modellgewichte
+ KV-Cache
+ Compute Buffer
+ temporäre Tensoren
+ Runtime-Overhead
Deshalb sollte eine Modell-Datei nicht den gesamten verfügbaren VRAM ausfüllen.
Beispiel: Q4_K_M auf einer 16-GB-GPU
Angenommen, ein Modell besitzt eine GGUF-Dateigröße von:
13,5 GB
Die GPU besitzt:
16 GB VRAM
Dann bleiben theoretisch:
16 GB - 13,5 GB
= 2,5 GB
Das kann knapp werden.
Denn insbesondere der KV-Cache kann bei langen Kontextfenstern mehrere Gigabyte beanspruchen.
Ein etwas kleineres Modell kann deshalb unter Umständen deutlich sinnvoller sein als ein Modell, dessen Gewichte gerade eben in den VRAM passen.
Was ist der KV-Cache?
Transformer berechnen während der Textgenerierung für jedes Token sogenannte Keys und Values der Attention-Schichten.
Damit diese Werte bei jedem neu erzeugten Token nicht vollständig neu berechnet werden müssen, werden sie gespeichert.
Dieser Speicherbereich heißt:
Key-Value Cache
oder kurz:
KV-Cache
Je länger der Kontext wird, desto größer wird dieser Cache.
Vereinfacht kann seine Größe ungefähr berechnet werden als:
KV-Cache =
2
× Anzahl Layer
× Anzahl KV-Heads
× Head Dimension
× Kontextlänge
× Bytes pro Wert
Der Faktor 2 entsteht durch:
Key + Value
KV-Cache am Beispiel Qwen3-30B-A3B
Qwen3-30B-A3B besitzt unter anderem:
48 Layer
4 KV-Heads
Head Dimension: 128
Bei einem FP16-KV-Cache mit 32.768 Tokens ergibt sich näherungsweise:
2
× 48
× 4
× 128
× 32.768
× 2 Byte
Das ergibt ungefähr:
3 GiB
allein für den KV-Cache.
Damit könnte eine stark vereinfachte Speicherrechnung beispielsweise so aussehen:
Modellgewichte:    18,6 GB
KV-Cache:          ~3,0 GB
Runtime/Buffer:    zusätzlich
--------------------------------
Gesamt:            >21 GB
Ob diese Werte exakt so auftreten, hängt stark von Backend, Cache-Quantisierung, Kontextlänge, Batch-Größe und GPU-Offloading ab.
Das Beispiel zeigt aber, warum Dateigröße und VRAM-Bedarf nicht dasselbe sind.
Kontextlänge kostet Speicher
Daraus ergibt sich eine wichtige Konsequenz:
Ein Modell kann mit
4.096 Tokens
problemlos laufen, aber bei
32.768 Tokens
plötzlich nicht mehr vollständig in den VRAM passen.
Der KV-Cache wächst grundsätzlich mit der Kontextlänge.
Deshalb kann das Reduzieren des Context Length in LM Studio oder llama.cpp erheblich Speicher sparen.
GPU-Offloading bei llama.cpp
Ein großer Vorteil von llama.cpp und GGUF besteht darin, dass nicht zwangsläufig das komplette Modell im Grafikspeicher liegen muss.
Teile können im normalen Arbeitsspeicher verbleiben.
Vereinfacht:
GPU:
Layer 0–30

RAM:
Layer 31–47
Dadurch kann beispielsweise ein Modell mit 20 GB Gewichtsdaten auch auf einer GPU mit 16 GB VRAM ausgeführt werden.
Der Nachteil:
Die CPU und insbesondere die Datenübertragung zwischen RAM und GPU werden stärker beteiligt.
Die Geschwindigkeit kann dadurch erheblich sinken.
Warum Unified Memory interessant ist
Systeme mit gemeinsamem Speicher zwischen CPU und GPU besitzen hier einen strukturellen Vorteil.
Ein Beispiel sind Apple-Silicon-Systeme.
Bei einem Rechner mit:
64 GB Unified Memory
können CPU und GPU grundsätzlich auf denselben Speicherpool zugreifen.
Bei einem klassischen PC mit
32 GB RAM
+
16 GB VRAM
handelt es sich dagegen um zwei getrennte Speicherbereiche.
Das bedeutet nicht automatisch, dass Unified Memory schneller ist. Es erleichtert aber das Ausführen von Modellen, deren Gewichte größer sind als der dedizierte VRAM einer typischen Consumer-GPU.
Quantisierung reduziert Speicher – MoE reduziert Berechnung
Damit kommen wir zur zweiten wichtigen Technik:
Mixture of Experts
Bei klassischen Transformer-Modellen handelt es sich häufig um sogenannte Dense Models.
Bei einem Dense Model werden für jedes Token grundsätzlich dieselben Feed-Forward-Netzwerke durchlaufen.
Besitzt ein Dense Model beispielsweise:
32 Milliarden Parameter
ist ein großer Teil dieser Parameter bei jeder Tokenberechnung beteiligt.
Bei einem Mixture-of-Experts-Modell ist ein Teil dieser Architektur dagegen in mehrere sogenannte Experts aufgeteilt.
Wie funktioniert ein MoE-Layer?
Ein stark vereinfachter MoE-Layer kann so aussehen:
                  ┌── Expert 1
                  ├── Expert 2
Token → Router ───├── Expert 3
                  ├── Expert 4
                  ├── Expert 5
                  └── Expert 6
Der Router bewertet für jedes Token, welche Experts am geeignetsten sind.
Bei einem Top-2-Routing könnte beispielsweise gelten:
Token
 ↓
Router
 ↓
Expert 2 + Expert 5
Die anderen Experts werden für dieses Token nicht berechnet.
Beim nächsten Token könnten dagegen
Expert 1 + Expert 4
aktiviert werden.
Die Experts sind keine einfachen Fachgebiete
Man liest gelegentlich Erklärungen wie:
Expert 1 = Mathematik
Expert 2 = Programmierung
Expert 3 = Deutsch
Expert 4 = Geschichte
Das ist zwar eine anschauliche Erklärung, technisch aber zu stark vereinfacht.
Die Experts werden während des Trainings nicht normalerweise explizit bestimmten menschlichen Fachgebieten zugeordnet.
Stattdessen lernen sie unterschiedliche interne Repräsentationen und Spezialisierungen.
Welche Expert-Kombination verwendet wird, ergibt sich aus dem trainierten Router.
Gesamtparameter und aktive Parameter
Bei MoE-Modellen müssen deshalb zwei Parameterzahlen unterschieden werden:
Total Parameters
und
Active Parameters
Ein Modell könnte beispielsweise besitzen:
30B Total
3B Active
Das bedeutet:
Das vollständige Modell enthält etwa 30 Milliarden Parameter.
Für die Berechnung eines Tokens wird aber nur ein Teil davon genutzt.
Diese Information ist für die Hardwareplanung enorm wichtig.
Beispiel 1: Mixtral 8x7B
Eines der bekanntesten frühen MoE-Modelle war Mixtral 8x7B von Mistral AI.
Es besitzt ungefähr:
47 Milliarden Gesamtparameter
13 Milliarden aktive Parameter
Mistral gibt für das Modell acht Experts an, von denen während der Verarbeitung jeweils zwei ausgewählt werden.
Der Name
8x7B
führt deshalb gelegentlich zu der falschen Rechnung:
8 × 7B = 56B
Die tatsächliche Gesamtparameterzahl liegt jedoch bei ungefähr 47B, da nicht sämtliche Teile des Netzes achtmal vorhanden sind.
Beispiel 2: Qwen3-30B-A3B
Bei Qwen3 wird die Architektur bereits im Namen angedeutet:
Qwen3-30B-A3B
Dabei steht:
30B ≈ Gesamtparameter

A3B ≈ ungefähr 3 Milliarden aktive Parameter
Genauer besitzt das Modell:
30,5B Gesamtparameter
3,3B aktive Parameter
128 Experts
8 aktive Experts pro Token
Dieses Verhältnis ist bemerkenswert:
30,5B vorhanden
aber
nur 3,3B aktiviert
Das bedeutet jedoch nicht, dass das Modell beim lokalen Einsatz nur so viel Speicher wie ein 3B-Modell benötigt.
MoE spart FLOPs – aber nicht automatisch VRAM
Das ist vermutlich das wichtigste Missverständnis bei Mixture-of-Experts-Modellen.
Angenommen, ein Modell besitzt:
30B Gesamtparameter
3B aktive Parameter
Für die Berechnung eines Tokens werden zwar nur ungefähr 3B Parameter aktiviert.
Trotzdem muss das System grundsätzlich Zugriff auf die Gewichte aller Experts haben.
Denn der Router kann beim nächsten Token vollkommen andere Experts auswählen.
Deshalb müssen die insgesamt 30B Parameter irgendwo gespeichert werden:
VRAM
RAM
oder
eine Kombination daraus
MoE reduziert also primär:
Rechenaufwand pro Token
und nicht automatisch:
Speicherbedarf der Modellgewichte
Beispiel 3: DeepSeek-V3
Wie weit dieses Konzept skaliert werden kann, zeigt DeepSeek-V3.
Das Modell besitzt:
671 Milliarden Gesamtparameter
37 Milliarden aktive Parameter pro Token
und verwendet eine Mixture-of-Experts-Architektur.
Das Verhältnis beträgt damit ungefähr:
671B vorhanden
37B aktiv
Ein vergleichbares Dense-Modell mit 671 Milliarden aktiven Parametern wäre während der Inferenz erheblich rechenintensiver.
Trotzdem bleiben die enormen Gesamtgewichte des MoE-Modells ein Speicherproblem.
Genau deshalb werden bei solchen Modellen MoE und Quantisierung häufig gemeinsam interessant.
Quantisierung und MoE ergänzen sich
Die beiden Verfahren optimieren unterschiedliche Ressourcen.
Quantisierung
Quantisierung reduziert:
Speicher pro Gewicht
Beispiel:
FP16
↓
Q4_K_M
Mixture of Experts
MoE reduziert:
berechnete Gewichte pro Token
Beispiel:
30B Gesamtparameter
↓
3B aktive Parameter
Zusammen ergibt sich:
Quantisiertes MoE-Modell
        │
        ├── viele Gesamtparameter
        ├── niedriger Speicherbedarf pro Parameter
        └── wenige aktive Parameter pro Token
Gerade für lokale KI-Systeme ist diese Kombination interessant.
Beispiel: Qwen3-30B-A3B Q4_K_M
Qwen3-30B-A3B zeigt das sehr anschaulich.
Das Modell besitzt:
30,5B Gesamtparameter
3,3B aktive Parameter
Die F16-Gewichte benötigen ungefähr:
61 GB
Als Q4_K_M-GGUF benötigt das Modell nur:
18,6 GB
Während der eigentlichen Berechnung werden aber trotzdem lediglich ungefähr:
3,3B Parameter
aktiviert.
Man kombiniert damit zwei unterschiedliche Einsparungen:
Quantisierung
61 GB → 18,6 GB Modellgewichte

MoE
30,5B → 3,3B aktive Parameter
Das erklärt, warum ein derartiges Modell trotz seiner 30 Milliarden Gesamtparameter erstaunlich effizient arbeiten kann.
Warum ist ein 30B-MoE nicht mit einem 3B-Dense-Modell gleichzusetzen?
Es wäre trotzdem falsch zu sagen:
Qwen3-30B-A3B ist eigentlich nur ein 3B-Modell.
Die ungefähr 3,3 Milliarden Parameter beschreiben lediglich die pro Token aktivierte Modellkapazität.
Das Modell kann auf die insgesamt 30,5 Milliarden Parameter seiner verschiedenen Experts zurückgreifen.
Ebenso ist es aber falsch, die Inferenzkosten einfach mit einem normalen 30B-Dense-Modell gleichzusetzen.
Man sollte deshalb bei MoE immer beide Angaben nennen:
Total Parameters
+
Active Parameters
Dense und MoE im Vergleich
| Eigenschaft | Dense | Mixture of Experts |
|---|---|---|
| Gesamtparameter | vollständig gemeinsames Modell | teilweise auf Experts verteilt |
| aktive Parameter | großer Teil des Modells | nur ausgewählte Experts |
| Routing | nein | ja |
| Rechenkosten | relativ stark an Modellgröße gekoppelt | stärker an aktive Parameter gekoppelt |
| Speicherbedarf | Gesamtgewichte | ebenfalls Gesamtgewichte |
| Architektur | einfacher | komplexer |
| Skalierung | teuer | sehr große Gesamtmodelle möglich |
Welche Zahl bestimmt die Geschwindigkeit?
Bei einem normalen Dense-Modell ist die Parameterzahl ein relativ brauchbarer erster Hinweis auf den Rechenaufwand.
Bei MoE ist das nicht mehr ausreichend.
Statt nur
30B
zu betrachten, sollte man auf Angaben wie
30B-A3B
achten.
Für die Inferenzgeschwindigkeit sind unter anderem relevant:
- Anzahl der aktiven Parameter
- Anzahl der Experts
- Speicherbandbreite
- GPU-Leistung
- Quantisierung
- Prompt Processing
- Batch-Größe
- Backend
- CPU/GPU-Offloading
Gerade bei lokalen LLMs ist Speicherbandbreite häufig mindestens genauso wichtig wie reine Rechenleistung.
Eine praktische VRAM-Abschätzung
Wer prüfen möchte, ob ein GGUF-Modell auf seine GPU passt, kann zunächst relativ pragmatisch rechnen.
Angenommen:
GGUF-Datei:      11,5 GB
KV-Cache:         2,0 GB
sonstige Buffer:  1,0 GB
Dann ergibt sich:
≈ 14,5 GB
Eine 16-GB-GPU könnte damit funktionieren.
Bei:
GGUF-Datei:      15,0 GB
KV-Cache:         3,0 GB
Buffer:           1,0 GB
liegt man dagegen bei:
≈ 19 GB
Dann muss entweder:
Kontext reduzieren

oder

KV-Cache quantisieren

oder

GPU-Offloading reduzieren

oder

kleinere Quantisierung verwenden
werden.
Die konkrete Speicherverwaltung hängt allerdings stark von der jeweiligen Runtime ab.
Die Modellgröße allein reicht nicht für die Hardwarewahl
Wenn man lokale LLMs vergleicht, sollte man deshalb mindestens folgende Werte berücksichtigen:
1. Gesamtparameter
2. aktive Parameter
3. Dense oder MoE
4. Quantisierung
5. GGUF-Dateigröße
6. Kontextlänge
7. KV-Cache
8. VRAM
9. RAM
10. Speicherbandbreite
Die Aussage
„Meine GPU kann Modelle bis 30B ausführen“
ist daher eigentlich zu ungenau.
Ein
30B FP16 Dense
hat vollkommen andere Anforderungen als ein
30B Q4_K_M Dense
und wiederum andere Eigenschaften als ein
30B-A3B Q4_K_M MoE
Was sollte man für lokale LLMs wählen?
Für viele lokale Anwendungen ist Q4_K_M ein sinnvoller Ausgangspunkt.
Beispielsweise:
Q4_K_M
→ wenn Speicher knapp ist

Q5_K_M
→ wenn etwas mehr Speicher vorhanden ist

Q6_K
→ wenn Qualität wichtiger als Speicherbedarf ist

Q8_0
→ wenn sehr viel Speicher vorhanden ist
Dabei sollte man jedoch nicht automatisch davon ausgehen, dass Q8 immer die sinnvollste Variante ist.
Wenn ein Q8-Modell nur durch starkes CPU-Offloading betrieben werden kann, während Q4_K_M vollständig auf die GPU passt, kann die kleinere Quantisierung in der Praxis erheblich schneller sein.
Ein praktisches Beispiel
Angenommen, zwei Varianten desselben Modells stehen zur Verfügung:
Q8_0
32 GB
und
Q4_K_M
18 GB
Das System besitzt:
24 GB VRAM
64 GB RAM
Q8_0 muss teilweise im RAM liegen.
Q4_K_M könnte dagegen nahezu vollständig von der GPU verarbeitet werden.
Obwohl Q8 mathematisch genauer ist, kann deshalb
Q4_K_M
für dieses konkrete System die praktisch bessere Variante sein.
Die Hardware sollte daher bei der Auswahl der Quantisierung immer mit betrachtet werden.
Fazit
Quantisierung und Mixture of Experts sind zwei der entscheidenden Technologien, die den lokalen Betrieb großer Sprachmodelle überhaupt praktikabel machen.
Quantisierung reduziert die Speicherkosten der Modellgewichte.
Ein Modell kann beispielsweise von:
FP16: ~61 GB
auf
Q4_K_M: ~18,6 GB
schrumpfen.
Mixture of Experts verfolgt dagegen einen vollkommen anderen Ansatz.
Ein Modell wie Qwen3-30B-A3B besitzt:
30,5 Milliarden Gesamtparameter
aktiviert aber pro Token nur ungefähr:
3,3 Milliarden Parameter
Ein großes Modell kann dadurch erheblich mehr Gesamtparameter besitzen, ohne dass sämtliche Parameter für jedes Token berechnet werden müssen.
Die wichtigste Unterscheidung lautet deshalb:
Quantisierung
    ↓
reduziert Speicher pro Parameter

Mixture of Experts
    ↓
reduziert aktive Parameter pro Token
Beides lässt sich kombinieren.
Genau deshalb sind Modelle wie Qwen3-30B-A3B besonders interessant für lokale KI-Anwendungen:
Viele Gesamtparameter
+
wenige aktive Parameter
+
Q4/Q5-Quantisierung
=
vergleichsweise hohe Modellkapazität bei beherrschbaren Hardwareanforderungen
Wer Modelle mit LM Studio, Ollama, llama.cpp oder OpenCode lokal betreibt, sollte daher nicht mehr nur auf die klassische Angabe wie „7B“, „30B“ oder „70B“ schauen.
Entscheidend ist vielmehr das Zusammenspiel aus:
Parameterzahl
×
MoE-Architektur
×
aktive Parameter
×
Quantisierung
×
Kontextlänge
×
KV-Cache
×
verfügbarem VRAM und RAM
Erst diese Werte zusammen geben ein realistisches Bild davon, wie groß ein Modell tatsächlich ist und wie gut es auf der eigenen Hardware laufen wird.